Cómo escribir mejores prompts en Claude sin activar el “elefante rosa”
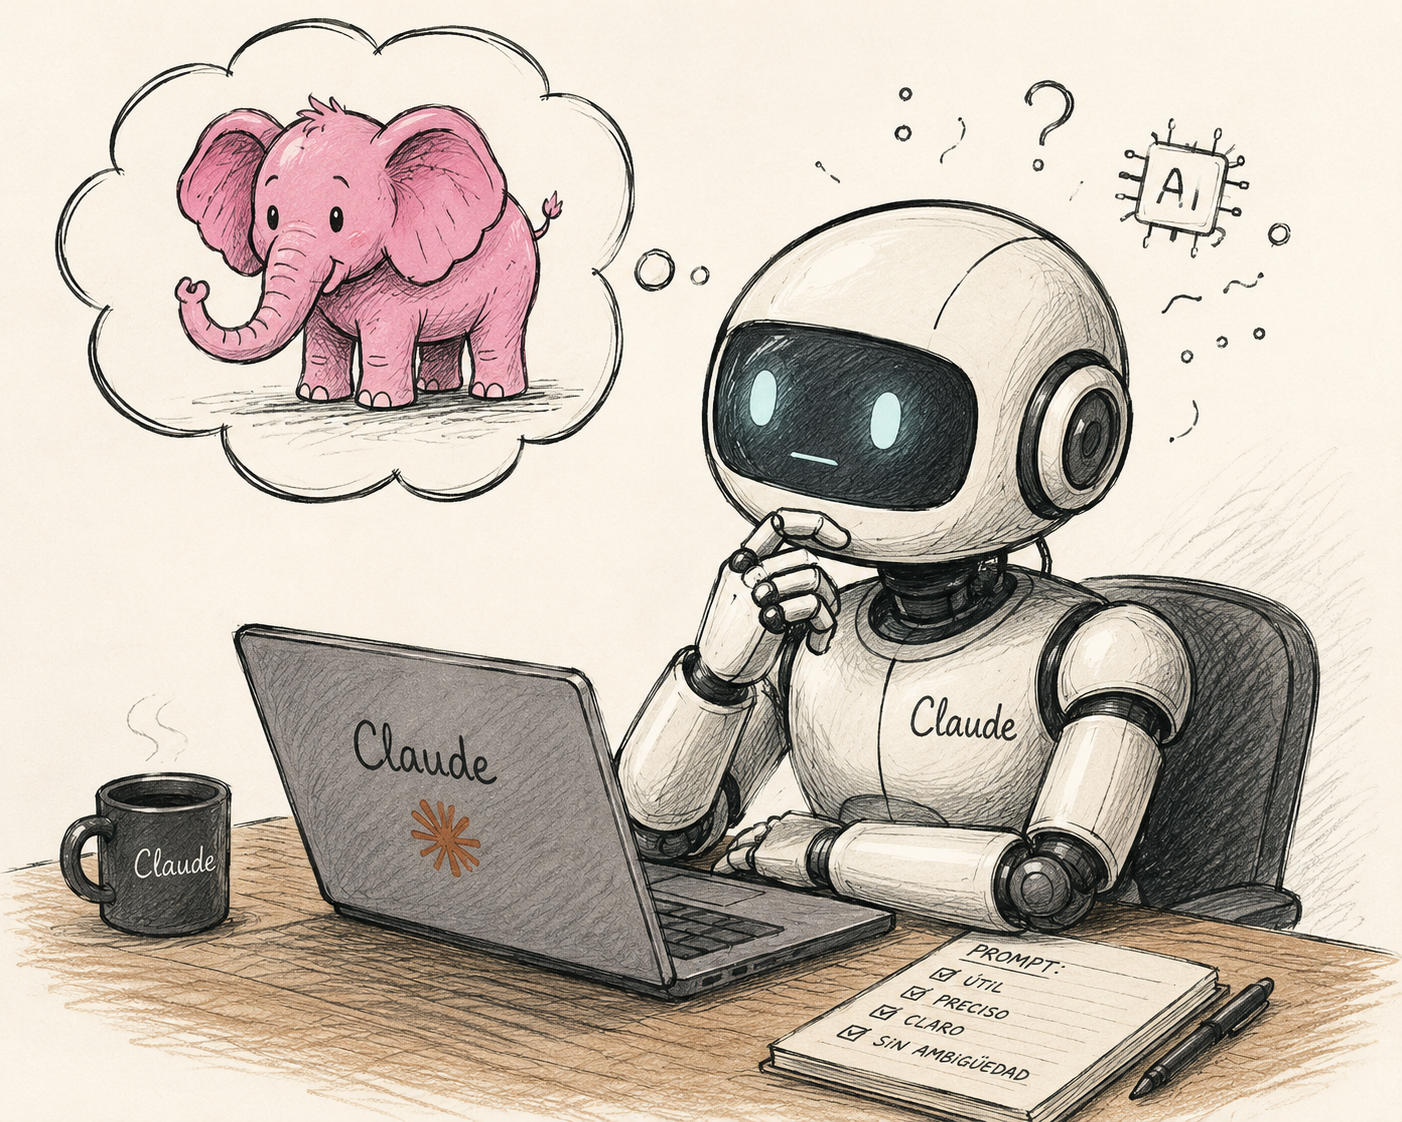
No pienses en un elefante rosa.
Ya lo hiciste.
Acabas de visualizar un elefante rosa, quizás con orejas enormes, quizás con sombrero, pero rosa sin duda. No pudiste evitarlo, y no es exactamente culpa tuya: tu cerebro necesita activar el concepto “elefante rosa” para poder verificar que no está pensando en él.
Lo interesante es que los modelos de lenguaje — incluido Claude — sufren una versión computacional extraordinariamente parecida del mismo problema.
Si alguna vez escribiste un prompt como:
- “No uses markdown”
- “No inventes información”
- “NUNCA uses jerga técnica”
- “NO hagas preguntas personales”
…y el modelo terminó haciendo exactamente aquello que intentabas evitar, no estás solo. Y, sobre todo, no es casualidad.
Investigadores de Carnegie Mellon, KAIST, la Universidad de Basilea y Anthropic llevan tiempo documentando por qué las instrucciones negativas son sistemáticamente problemáticas en LLMs. Y la solución, curiosamente, se parece mucho a lo que funciona también con humanos: en lugar de intentar suprimir un comportamiento, describe el comportamiento que sí quieres.
El origen del problema: Wegner y el oso blanco
Todo empieza bastante antes de la IA.
En 1987, el psicólogo Daniel Wegner publicó uno de los experimentos más citados de la psicología cognitiva moderna. A un grupo de participantes se les pidió algo aparentemente sencillo: intentar no pensar en un oso blanco.
El resultado fue exactamente el contrario.
Pensaron en osos blancos constantemente.
Y lo más interesante vino después. Cuando se levantó la restricción, quienes habían intentado suprimir el pensamiento experimentaron un fuerte efecto rebote: pensaban todavía más en osos blancos que quienes nunca habían intentado evitarlos.
Wegner desarrolló después una explicación elegante y bastante cruel a la vez. El cerebro funciona mediante dos procesos simultáneos: uno consciente que intenta dirigir la atención lejos del pensamiento prohibido y otro automático que monitoriza continuamente si ese pensamiento está apareciendo.
La paradoja es brillante.
Para comprobar que no estás pensando en X… primero tienes que activar X.
Ese “monitor irónico” necesita representar mentalmente el concepto que intenta evitar.
Y ahí es donde el paralelismo con los LLMs empieza a ponerse interesante.
El problema del elefante rosa en los modelos de lenguaje
Varios papers recientes han formalizado este fenómeno bajo un nombre bastante apropiado: el problema del elefante rosa.
La idea es sencilla. Cuando le dices a un modelo:
“No hables de elefantes”
…el modelo necesita procesar “elefantes” para interpretar la instrucción.
Y eso aumenta precisamente la saliencia del concepto que querías excluir.
La explicación técnica tiene bastante sentido cuando entiendes mínimamente cómo funcionan los transformers.
Los modelos no “restan” conceptos.
Añadir un “no” delante no elimina el embedding asociado al concepto. Simplemente crea una representación nueva donde el concepto sigue estando presente junto a la negación.
Es decir, “No uses markdown” sigue activando “markdown”.
Y como las palabras de contenido pesan mucho más que palabras funcionales como “no”, “nunca” o “evita”, el modelo termina prestando más atención precisamente a aquello que intentabas suprimir.
La ironía es bastante bonita, la verdad.
Lo que la arquitectura transformer no puede hacer bien
Aquí aparece una de las partes más interesantes del problema.
Los LLMs se entrenan prediciendo el siguiente token más probable. Cuando procesan una instrucción como:
“No hables sobre elefantes”
…el concepto estadísticamente dominante sigue siendo “elefantes”.
La palabra “no” tiene que competir contra millones de asociaciones positivas presentes en los datos de entrenamiento.
Y además ocurre otra cosa: los mecanismos de atención priorizan de forma natural palabras con más carga semántica. Sustantivos y verbos atraen mucha más atención que partículas funcionales como “no”.
Por eso la negación suele procesarse de forma incompleta o débil.
De hecho, investigaciones recientes muestran algo bastante contraintuitivo: modelos más grandes pueden comportarse peor con prompts negados porque son mejores modelando asociaciones estadísticas fuertes.
En otras palabras:
Cuanto más potente es el modelo… más “vive” el concepto que intentas prohibir.
Anthropic lo dice bastante claro
La documentación oficial de Anthropic aborda este problema de forma sorprendentemente directa.
Una de sus recomendaciones principales para Claude 4 es:
 dile al modelo qué hacer, no qué no hacer.
Y cuanto más avanzados son los modelos, más importante se vuelve esto.
Claude 4.x sigue instrucciones con mucha más precisión y literalidad que generaciones anteriores. Eso mejora enormemente la calidad… pero también amplifica los efectos de una mala formulación.
Por eso instrucciones tipo:
- “NUNCA”
- “JAMÁS”
- “ABSOLUTAMENTE NO”
suelen ser contraproducentes.
No refuerzan la restricción.
Refuerzan el concepto.
La diferencia entre prohibir y sustituir
Aquí está realmente la clave práctica.
El problema no se resuelve suprimiendo.
Se resuelve sustituyendo.
No:
“No uses lenguaje técnico”
Sí:
“Usa lenguaje claro para una audiencia no especializada”
No:
“No divagues”
Sí:
“Cada párrafo debe aportar información nueva o avanzar el argumento”
Parece un matiz pequeño.
Pero arquitectónicamente es una diferencia enorme.
En el primer caso activas el comportamiento no deseado.
En el segundo activas directamente el comportamiento correcto.
Tres patrones que funcionan mucho mejor
La investigación y la práctica convergen bastante en tres enfoques.
Sustitución explícita
Describe únicamente el comportamiento deseado. Es el patrón más robusto.
Contexto para restricciones inevitables
Cuando realmente necesitas evitar algo, explicar el motivo mejora muchísimo el cumplimiento.
“No uses tablas” funciona mucho mejor si añades:
“Este contenido se mostrará en un cliente de email que no soporta tablas HTML”
La restricción deja de ser arbitraria.
Declaraciones descriptivas
Anthropic usa esto incluso en sus propios system prompts.
En lugar de:
“No afirmes ser humano”
Usa:
“Claude no afirma ser humano”
Describe el comportamiento en vez de prohibirlo.
Y funciona mejor.
Lo importante de verdad
La convergencia entre psicología cognitiva y arquitectura transformer es bastante fascinante.
El mismo mecanismo que hace que pienses en un elefante rosa aparece cuando un LLM intenta “no” hablar de algo.
Y cuanto mejores se vuelven los modelos…
Más importante se vuelve cómo formulas cada instrucción.
Y esto no afecta solo al prompting “técnico”. También cambia cómo usamos la IA en contextos reales de negocio, automatización y ventas. Si quieres profundizar en esa parte más aplicada, te recomiendo también este episodio sobre inteligencia artificial en ventas B2B.
Porque cada “no” dentro de un prompt es, en cierto modo, una pequeña apuesta contra la propia arquitectura.
La conclusión
La supresión no funciona demasiado bien.
Ni en humanos.Ni en Claude.
La sustitución sí.
